""
Mostrando las entradas con la etiqueta Matplotlib. Mostrar todas las entradas

jueves, 12 de febrero de 2026

MatPlotLib. WordCloud

El WordCloud función desde wordcloud permite crear nubes de palabras en Python. La función proporciona varios métodos, pero generate es el que necesitas para crear una nube de palabras de una cadena de texto. Tenga en cuenta que, de forma predeterminada, el tamaño de la imagen es 400x200, pero puede personalizar el tamaño con width y height, como en el ejemplo siguiente o usando scale (el valor predeterminado es 1), que se recomienda para nubes de palabras grandes.

Vale la pena mencionar que si quieres que las palabras se repitan, establece repeat = True. Esto es muy útil para crear una nube de palabras a partir de una sola palabra o textos pequeños.


Ejemplo 1:

>>import matplotlib.pyplot as plt
>>from wordcloud import WordCloud

>>text = input("Favor ingresar el texto para la nube de palabras: ")
>>wc = WordCloud(width = 300, height = 300, repeat = "true").generate(text)

>># Remove the axis and display the data as image
>>plt.axis("off")
>>plt.imshow(wc, interpolation = "bilinear")

>># plt.show()


Ejemplo 2:

>>import numpy as np
>>import matplotlib.pyplot as plt
>>from wordcloud import WordCloud

>>text = input("Favor ingresar el texto para Wordcloud circular: ")

>># Circle mask
>>x, y = np.ogrid[:300, :300]
>>mask = (x - 150) ** 2 + (y - 150) ** 2 > 130 ** 2
>>mask = 255 * mask.astype(int)

>>wc = WordCloud(background_color = "white", repeat = True, mask = mask)
>>wc.generate(text)

>>plt.axis("off")
>>plt.imshow(wc, interpolation = "bilinear")

>># plt.show()

Ejemplo 3:

>>import numpy as np
>>import matplotlib.pyplot as plt
>>from wordcloud import WordCloud
>>from PIL import Image
>>from io import BytesIO
>>mport requests

>>text = "PPI, Python Para Ingenieros"

>># From URL
>>response = requests.get("https://raw.githubusercontent.com/R-CoderDotCom/samples/main/wordcloud-mask.jpg")
>>mask = np.array(Image.open(BytesIO(response.content)))

>># From local
>># mask = np.array(Image.open("file_name.png"))

>>wc = WordCloud(background_color = "white", repeat = True, mask = mask)
>>wc.generate(text)

>>plt.axis("off")
>>plt.imshow(wc, interpolation = "bilinear")

>>plt.show()


sábado, 7 de febrero de 2026

Otra librería para graficar en Python. Plotly

 Fuente: https://python-charts.com/plotly/

TODOS GRÁFICOS DE PLOTLY

Los siguientes son todos los tutoriales de plotly de este sitio. Dentro de cada tutorial encontrarás varios ejemplos con código reproducible para aprender paso a paso cómo crear y personalizar el gráfico

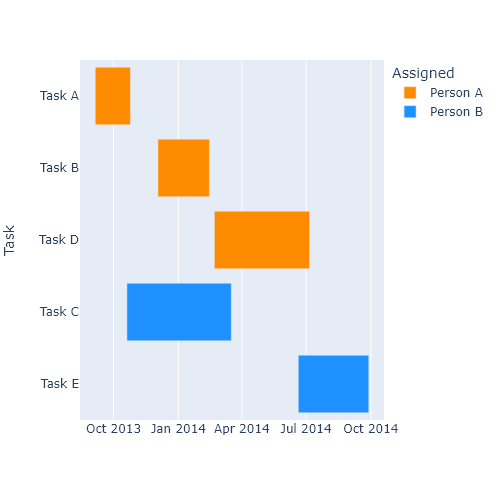
Diagrama de Gantt en Plotly
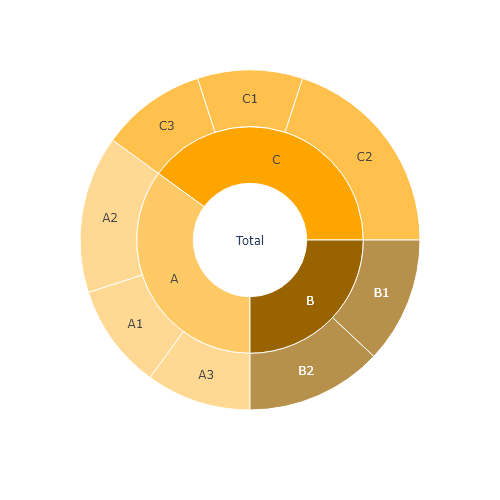
Gráficos de rayos de sol en plotly
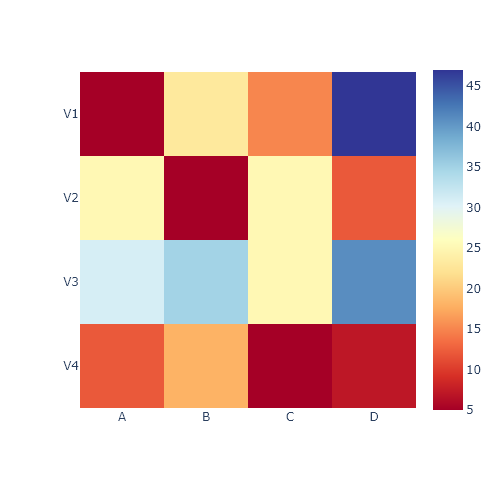
Mapas de calor en plotly con imshow
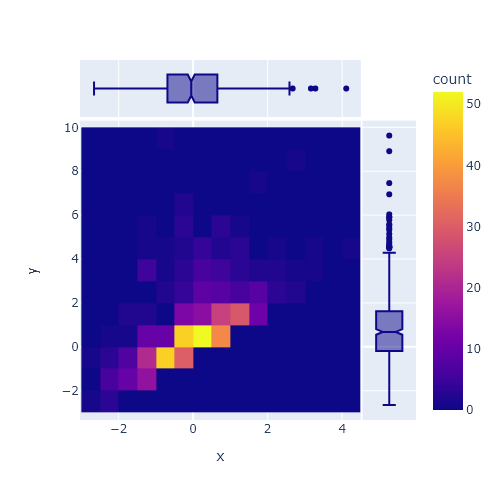
Histogramas 2D en plotly
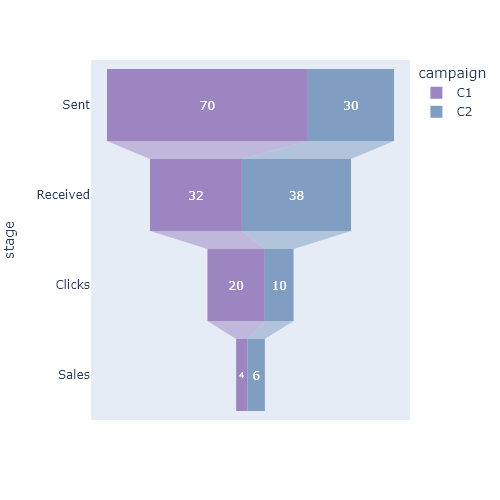
Gráficos de embudo en plotly
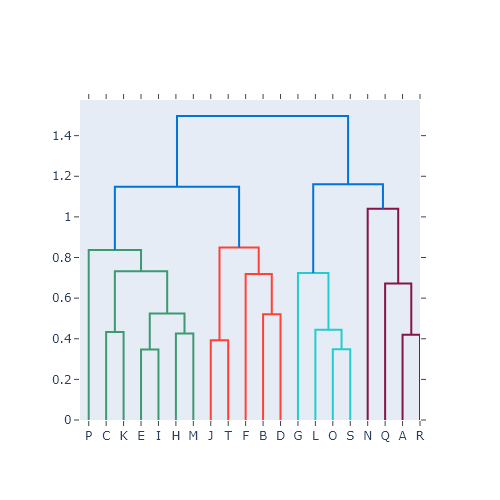
Dendrograma en plotly
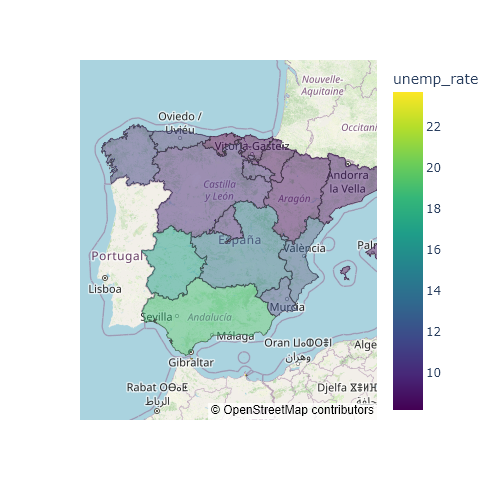
Mapas coropléticos en plotly
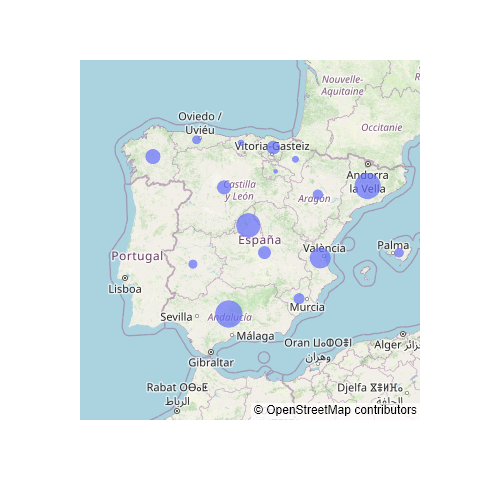
Mapa de burbujas en plotly
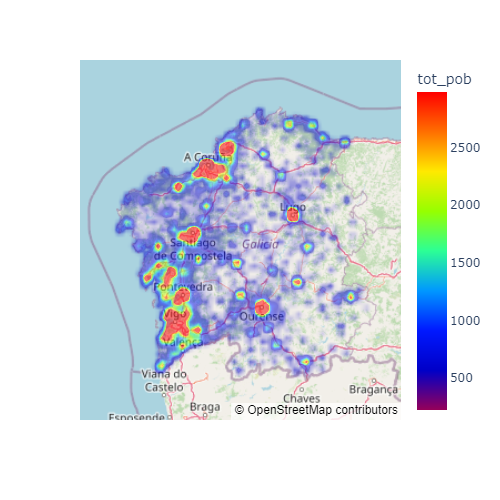
Mapa de calor en un mapa (mapa de calor espacial) en plotly
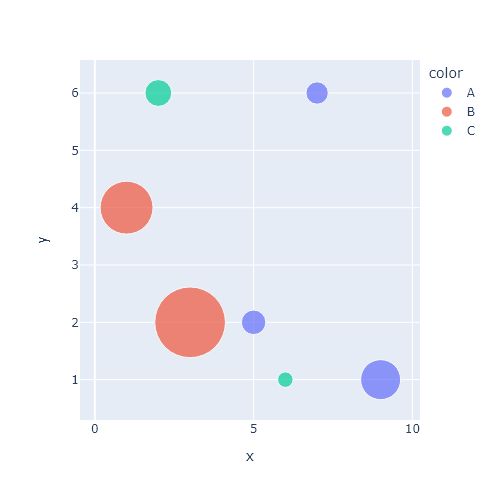
Gráfico de burbujas en plotly
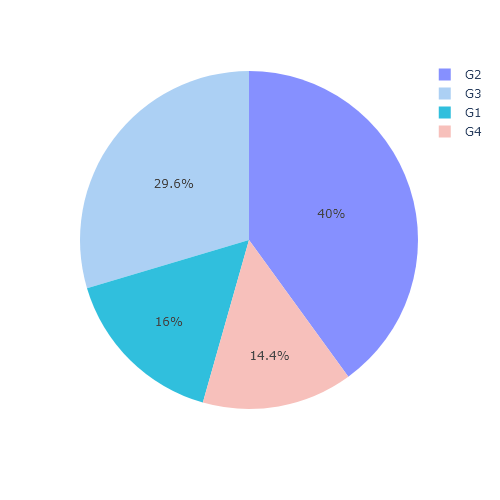
Gráficos circulares en plotly
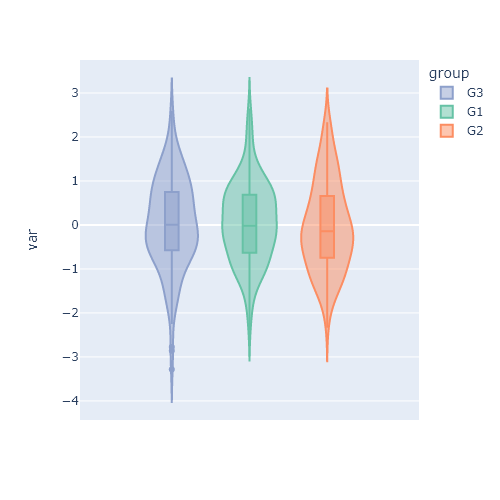
Tramas de violín en plotly
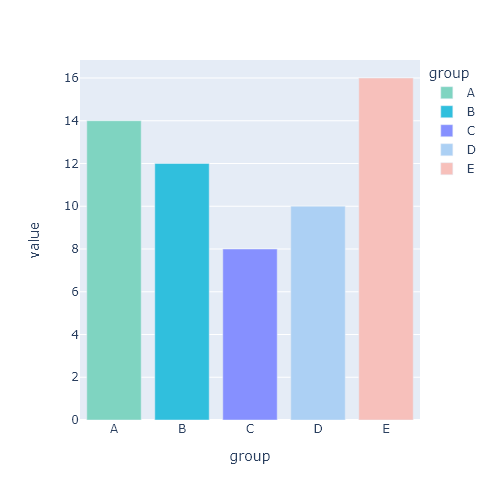
Gráfico de barras en plotly
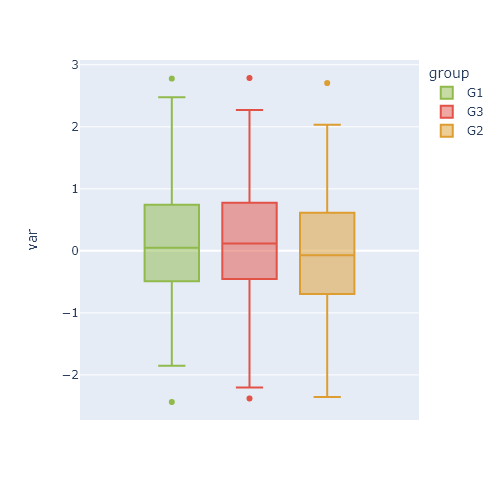
Diagrama de caja en plotly
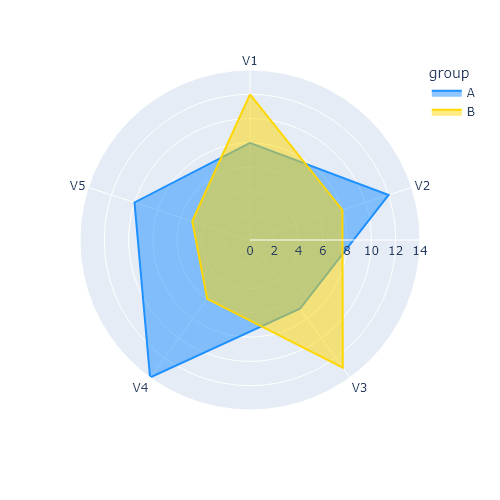
Gráfico de radar en plotly
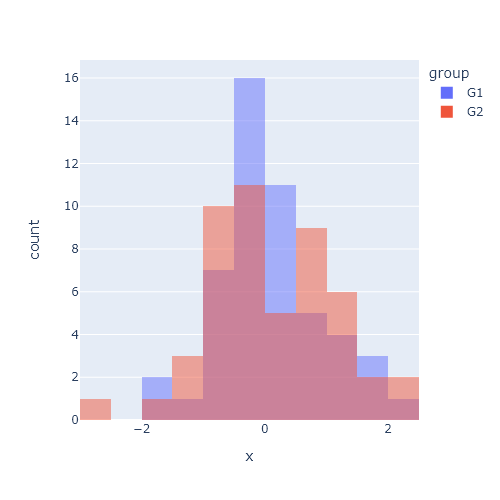
Histogramas en plotly
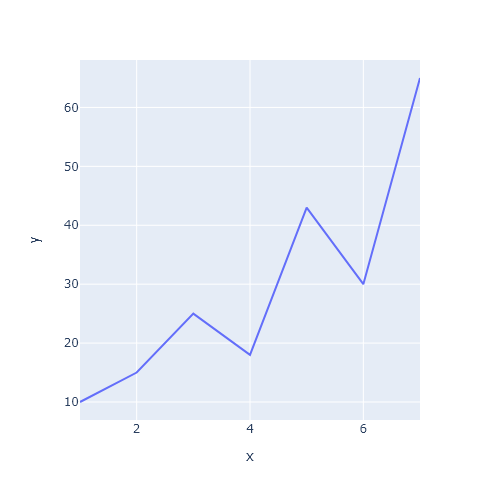
Gráfico de líneas en plotly
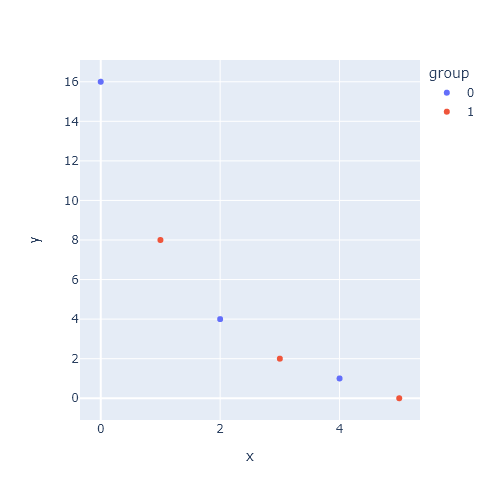
Diagrama de dispersión en plotly

sábado, 31 de enero de 2026

Python for Data Science. Histogramas

Fuente: Google & Coursera

Como ha ido aprendiendo, el propósito del Análisis exploratorio de datos (EDA) es justo lo que su nombre indica: explorar y analizar los datos. Como profesional de los datos, casi siempre empezará con una pregunta u objetivo guía, como "¿Dónde se encuentran los mayores emisores de dióxido de carbono?" o "Determinar las características de las personas con más probabilidades de comprar el producto X" Reflexionar sobre ello a menudo a lo largo del proceso crea una fuerza motriz que te mantiene en el buen camino.

Una de las herramientas más importantes a su disposición a la hora de explorar datos es el histograma. Un histograma es una representación gráfica de una distribución de frecuencias, que muestra la frecuencia con la que aparece cada valor en un conjunto de datos o variable. Es esencial que los profesionales de los datos comprendan las distribuciones de sus datos, ya que este conocimiento impulsa muchas decisiones posteriores en torno al diseño de experimentos, el modelado y el análisis posterior. En esta lectura, aprenderás sobre los histogramas, qué son, cómo hacerlos y cómo interpretarlos.

Introducción a los histogramas

Los histogramas se utilizan habitualmente para ilustrar la forma de una distribución, incluida la presencia de valores atípicos, el centro de la distribución y la dispersión de los datos. Los histogramas se representan normalmente mediante una serie de barras, donde cada barra representa un rango de valores. La altura de las barras representa la frecuencia o el recuento de los puntos de datos dentro de ese rango.

El siguiente ejemplo es un histograma del número de segundos transcurridos entre las erupciones del géiser Old Faithful en el Parque Nacional de Yellowstone, Wyoming, Estados Unidos.


El eje x representa el número de segundos entre erupciones. El eje y representa el número de erupciones. Así, como indica la segunda barra del gráfico, hay 20 erupciones que se produjeron tras un tiempo de espera de 45-49 segundos.

La importancia de los histogramas

Los histogramas son una herramienta esencial para comprender las características de un conjunto de datos. Proporcionan una representación visual de la distribución de los datos y permiten a los profesionales de datos identificar patrones, tendencias o valores atípicos dentro de los datos. Los histogramas también pueden ayudar a los profesionales de datos a elegir pruebas y modelos estadísticos apropiados para los datos y a determinar si los datos cumplen los supuestos necesarios para el análisis. Los histogramas se utilizan ampliamente en cualquier campo y situación que requiera cualquier tipo de análisis de datos, incluidas las finanzas, la sanidad, la ingeniería y las ciencias sociales.

Cómo interpretar histogramas

Interpretar histogramas implica comprender la forma, el centro y la dispersión de la distribución. Hay varias formas comunes de histogramas, incluyendo:

1. Simétrico: Un histograma simétrico tiene una curva en forma de campana con un pico en el centro, lo que indica que los datos se distribuyen uniformemente alrededor de la media. También se conoce como distribución normal o gaussiana.


2. Sesgado: Un histograma sesgado tiene una cola más larga en un lado que en el otro. Un histograma sesgado a la derecha tiene una cola más larga en el lado derecho, lo que indica que hay más puntos de datos en el lado izquierdo del histograma.


Una distribución sesgada a la izquierda tiene una cola más larga en el lado izquierdo, lo que indica que hay más puntos de datos en el lado derecho.


3. Bimodal: Un histograma bimodal tiene dos picos distintos, lo que indica que los datos tienen dos modos.


4.
Uniforme: Un histograma uniforme tiene una distribución plana, lo que indica que todos los puntos de datos están distribuidos uniformemente.


Los ejemplos proporcionados no son las únicas distribuciones que encontrarás, pero son algunas de las más comunes. Pronto aprenderás más sobre las distribuciones.

Ahora, vuelve al histograma del géiser Old Faithful del principio de esta lectura. Pregúntate: ¿qué tipo de distribución representa ese gráfico? Además de la forma, es importante entender el centro y la dispersión. El centro de la distribución suele estar representado por la media o mediana, mientras que la dispersión está representada por la desviación estándar o rango de los datos. El centro y la dispersión pueden proporcionar información sobre la concentración y variabilidad de los datos.

Cómo crear histogramas

Las bibliotecas Seaborn y Matplotlib de Python proporcionan opciones sencillas y potentes para crear histogramas.

plt.hist(x, bins=10, ...)

Para generar un histograma en matplotlib, utilice la función hist() del módulo pyplot. La función puede tomar muchos argumentos diferentes, pero los principales son:

  • x: Una secuencia de valores que representan los datos que desea trazar. Puede ser una lista, tupla, matriz NumPy, serie Pandas, etc.

  • bins: El número de bins en los que quieres ordenar los datos. El valor por defecto es 10, pero este parámetro puede ser un int, una secuencia o una cadena. Si utiliza una secuencia, ésta define los bordes de las casillas, incluyendo el borde izquierdo de la primera casilla y el borde derecho de la última. En otras palabras, si bins = [1, 3, 5, 7], entonces el primer bin es [1-3) (incluyendo 1, pero excluyendo 3) y el segundo [3-5). Sin embargo, el último bin es [5-7], que incluye el 7. Una cadena se refiere a una estrategia de binning predefinida soportada por numpy. Consulta la documentación para obtener más información.

El siguiente ejemplo demuestra cómo generar el histograma del géiser Old Faithful desde el principio de esta lectura usando la función plt.hist().

>># Plot histogram with matplotlib pyplot
>>plt.hist(df['seconds'], bins=range(40, 101, 5))
>>plt.xticks(range(35, 101, 5))
>>plt.yticks(range(0, 61, 10))
>>plt.xlabel('seconds')
>>plt.ylabel('count')
>>plt.title('Old Faithful geyser - time between eruptions')
>>plt.show();


En este caso, los datos que se grafican son la columna de segundos del marco de datos. Los intervalos comienzan en 40 segundos y van hasta 100 segundos en pasos de cinco, para un total de 12 intervalos.

sns.histplot(x, bins, binrange, binwidth ...)

Una forma de generar un histograma en Seaborn es utilizar la función sns.histplot(). Al igual que la función matplotlib, sns.histplot() puede tomar muchos argumentos. Éstos son algunos importantes:

  • x: La secuencia de datos. Igual que plt.hist()

  • bins: Lo mismo que plt.hist()

  • binrange: Valor mínimo y máximo de los bordes de los contenedores; puede utilizarse con bins o binwidth; por defecto son los extremos de los datos

  • binwidth: Anchura de cada bin, anula bins pero puede usarse con binrange

El siguiente ejemplo es el código utilizado para generar el histograma del géiser Old Faithful utilizando la función seaborn histplot() . Utiliza todos los parámetros mencionados anteriormente. Ejecute este bloque de código para generar un histograma.

Observe en este caso que binrange se define de 40 a 100 y binwidth se establece en 5. Esto produce los mismos resultados que definir bins=range(40, 101, 5). Este ejemplo también hace uso de un par de parámetros de estilo especificando un color concreto mediante notación de código hexadecimal y estableciendo el nivel de saturación del color al 100%, como indica el parámetro alpha.

>># Plot histogram with seaborn
>>ax = sns.histplot(df['seconds'], binrange=(40, 100), binwidth=5, color='#4285F4', alpha=1)
>>ax.set_xticks(range(35, 101, 5))
>>ax.set_yticks(range(0, 61, 10))
>>plt.title('Old Faithful geyser - time between eruptions')
>>plt.show();


Puntos clave

Los histogramas ayudan a los profesionales de los datos a comprender las distribuciones de frecuencia de sus conjuntos de datos y variables. El conocimiento de la forma y el tipo de distribución de los datos afectará a importantes decisiones posteriores, como las pruebas estadísticas y la selección de la arquitectura del modelo. Además, conocer la forma de los datos proporciona información valiosa sobre la historia que cuentan los datos, ya que ayuda a comprender sus tendencias de distribución.


lunes, 3 de noviembre de 2025

Seaborn, Librería de Python que integra MatplotLib y Pandas


Una introducción a seaborn 

Seaborn es una biblioteca para crear gráficos estadísticos en Python. Se basa en matplotlib y se integra estrechamente con las estructuras de datos de pandas .

Seaborn te ayuda a explorar y comprender tus datos. Sus funciones de graficación operan sobre dataframes y arrays que contienen conjuntos de datos completos y realizan internamente el mapeo semántico y la agregación estadística necesarios para generar gráficos informativos. Su API declarativa, orientada a conjuntos de datos, te permite concentrarte en el significado de los diferentes elementos de tus gráficos, en lugar de en los detalles de cómo dibujarlos.

Aquí tenéis un ejemplo de lo que puede hacer Seaborn:

>># Import seaborn

>>import seaborn as sns

>># Apply the default theme

>>sns.set_theme()

>># Load an example dataset

>>tips = sns.load_dataset("tips")


>># Create a visualization

>>sns.relplot(

>>    data=tips,

>>    x="total_bill", y="tip", col="time",

>>    hue="smoker", style="smoker", size="size",

>>)


Han ocurrido varias cosas aquí. Vamos a repasarlas una por una:

# Import seaborn
import seaborn as sns

Seaborn es la única biblioteca que necesitamos importar para este sencillo ejemplo. Por convención, se importa con la sintaxis abreviada sns.

Seaborn utiliza Matplotlib para generar sus gráficos. Para trabajar de forma interactiva, se recomienda usar una interfaz Jupyter/IPython en modo Matplotlib ; de lo contrario, tendrá que llamar a la función correspondiente matplotlib.pyplot.show()cada vez que desee visualizar el gráfico.

# Apply the default theme
sns.set_theme()

Esto utiliza el sistema rcParam de matplotlib y afectará la apariencia de todos los gráficos de matplotlib, incluso si no los creas con seaborn. Además del tema predeterminado, existen varias opciones adicionales , y puedes controlar de forma independiente el estilo y la escala del gráfico para adaptar rápidamente tu trabajo a diferentes contextos de presentación (por ejemplo, crear una versión de tu figura con fuentes legibles para proyectar durante una charla). Si te gustan los valores predeterminados de matplotlib o prefieres otro tema, puedes omitir este paso y seguir utilizando las funciones de graficación de seaborn.

# Load an example dataset
tips = sns.load_dataset("tips")

La mayor parte del código en la documentación utiliza la load_dataset()función para acceder rápidamente a un conjunto de datos de ejemplo. Estos conjuntos de datos no tienen nada de especial: son simplemente dataframes de pandas, y podríamos haberlos cargado pandas.read_csv()o creado manualmente. La mayoría de los ejemplos en la documentación especifican datos mediante dataframes de pandas, pero seaborn es muy flexible en cuanto a las estructuras de datos que acepta.

# Create a visualization
sns.relplot(
    data=tips,
    x="total_bill", y="tip", col="time",
    hue="smoker", style="smoker", size="size",
)

Este gráfico muestra la relación entre cinco variables del conjunto de datos `tips` mediante una sola llamada a la función `seaborn` relplot(). Observe que solo proporcionamos los nombres de las variables y sus funciones en el gráfico. A diferencia de cuando se usa `matplotlib` directamente, no fue necesario especificar atributos de los elementos del gráfico en términos de valores de color o códigos de marcadores. Internamente, `seaborn` se encargó de la traducción de los valores del dataframe a argumentos que `matplotlib` entiende. Este enfoque declarativo le permite centrarse en las preguntas que desea responder, en lugar de en los detalles de cómo controlar `matplotlib`.

Una API de alto nivel para gráficos estadísticos 

No existe una única forma óptima de visualizar datos. Diferentes preguntas se responden mejor con diferentes gráficos. Seaborn facilita el cambio entre distintas representaciones visuales mediante una API consistente orientada a conjuntos de datos.

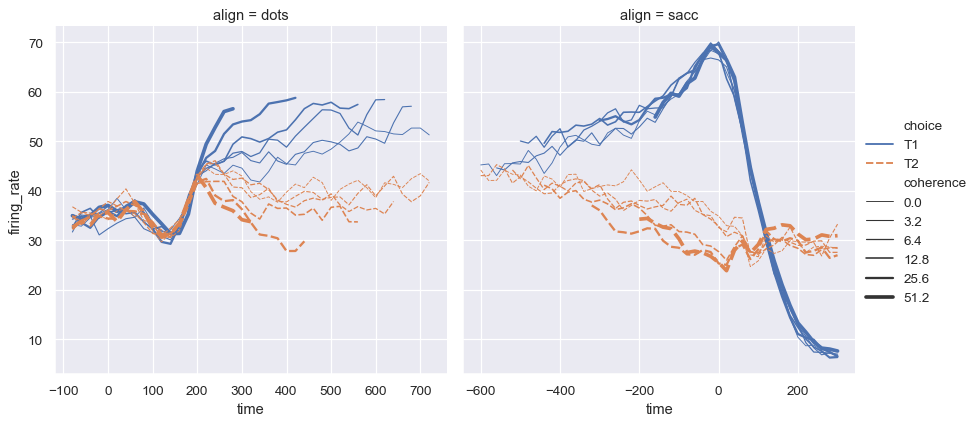
La función relplot()recibe ese nombre porque está diseñada para visualizar diversas relaciones estadísticas . Si bien los diagramas de dispersión suelen ser eficaces, las relaciones en las que una variable representa una medida del tiempo se representan mejor mediante una línea. La relplot()función cuenta con un práctico kindparámetro que permite cambiar fácilmente a esta representación alternativa.

dots = sns.load_dataset("dots")
sns.relplot(
    data=dots, kind="line",
    x="time", y="firing_rate", col="align",
    hue="choice", size="coherence", style="choice",
    facet_kws=dict(sharex=False),
)
../_images/introduction_11_0.png

Observe cómo se utilizan los parámetros `x` e ` sizey` styletanto en el gráfico de dispersión como en el de líneas, pero afectan a ambas visualizaciones de forma diferente: modifican el área del marcador y el símbolo en el gráfico de dispersión, mientras que en el de líneas modifican el ancho de línea y el interlineado. No fue necesario tener en cuenta esos detalles, lo que nos permitió centrarnos en la estructura general del gráfico y en la información que queríamos transmitir.

Estimación estadística 

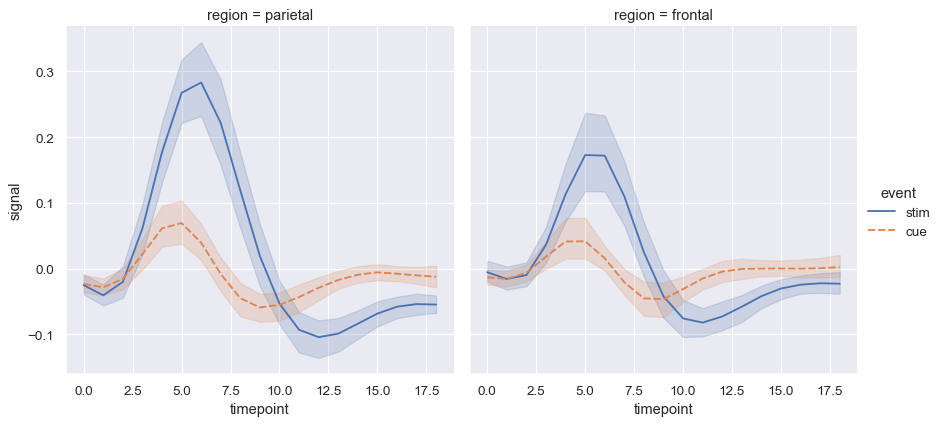
A menudo, nos interesa el valor promedio de una variable en función de otras. Muchas funciones de Seaborn realizan automáticamente la estimación estadística necesaria para responder a estas preguntas:

fmri = sns.load_dataset("fmri")
sns.relplot(
    data=fmri, kind="line",
    x="timepoint", y="signal", col="region",
    hue="event", style="event",
)
../_images/introduction_13_0.png

Cuando se estiman valores estadísticos, seaborn utilizará el remuestreo bootstrap para calcular intervalos de confianza y dibujar barras de error que representen la incertidumbre de la estimación.
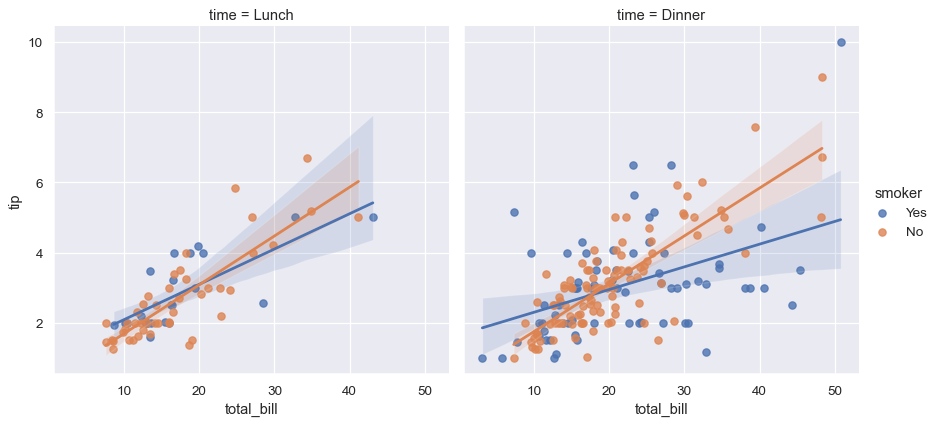
La estimación estadística en Seaborn va más allá de la estadística descriptiva. Por ejemplo, es posible mejorar un diagrama de dispersión incluyendo un modelo de regresión lineal (y su incertidumbre) mediante lmplot():

sns.lmplot(data=tips, x="total_bill", y="tip", col="time", hue="smoker")
../_images/introduction_15_0.png

Representaciones distribucionales 

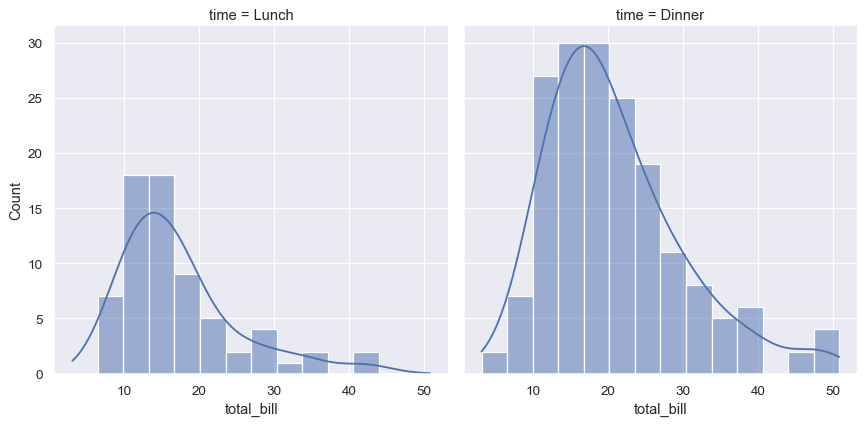
Los análisis estadísticos requieren conocer la distribución de las variables en el conjunto de datos. La función seaborn displot()admite varios métodos para visualizar distribuciones. Estos incluyen técnicas clásicas como los histogramas y métodos computacionalmente intensivos como la estimación de densidad kernel:

sns.displot(data=tips, x="total_bill", col="time", kde=True)
../_images/introduction_17_0.png

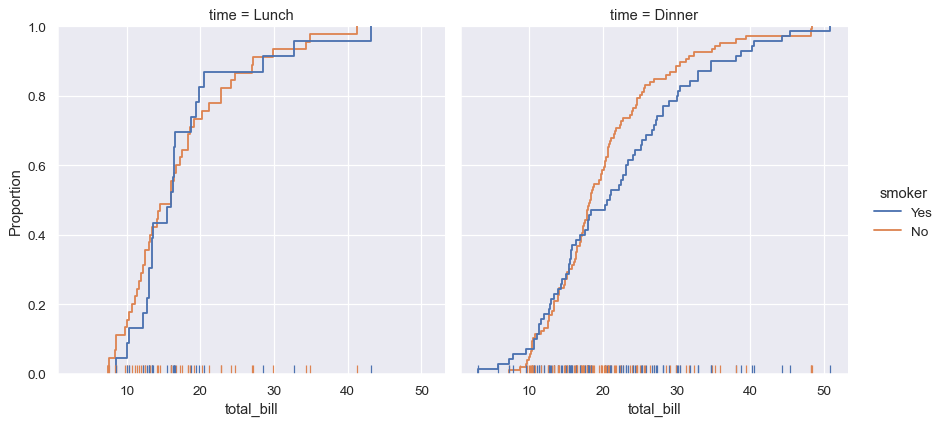
Seaborn también intenta promover técnicas poderosas pero menos conocidas, como el cálculo y la representación gráfica de la función de distribución acumulativa empírica de los datos:

sns.displot(data=tips, kind="ecdf", x="total_bill", col="time", hue="smoker", rug=True)
../_images/introduction_19_0.png

Gráficos para datos categóricos 

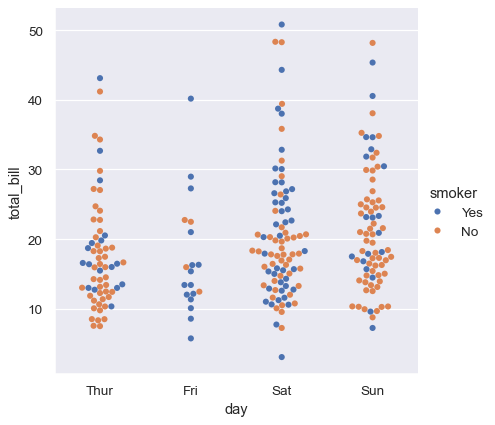
En Seaborn, existen varios tipos de gráficos especializados orientados a la visualización de datos categóricos. Se puede acceder a ellos mediante [método/función/método] catplot(). Estos gráficos ofrecen diferentes niveles de detalle. En el nivel más detallado, puede que desee ver todas las observaciones dibujando un gráfico de dispersión: un diagrama de dispersión que ajusta las posiciones de los puntos a lo largo del eje categórico para que no se superpongan.

sns.catplot(data=tips, kind="swarm", x="day", y="total_bill", hue="smoker")
../_images/introduction_21_0.png

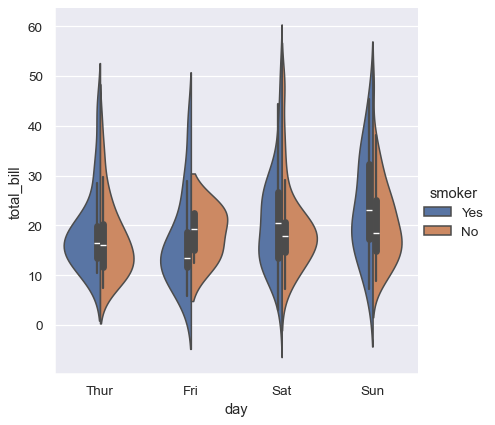
Alternativamente, se podría utilizar la estimación de densidad kernel para representar la distribución subyacente de la que se muestrean los puntos:

sns.catplot(data=tips, kind="violin", x="day", y="total_bill", hue="smoker", split=True)
../_images/introduction_23_0.png

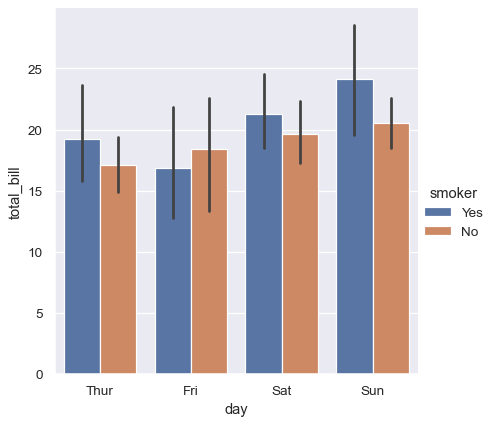
O bien, podría mostrar únicamente el valor medio y su intervalo de confianza dentro de cada categoría anidada:

sns.catplot(data=tips, kind="bar", x="day", y="total_bill", hue="smoker")
../_images/introduction_25_0.png

Vistas multivariadas en conjuntos de datos complejos 

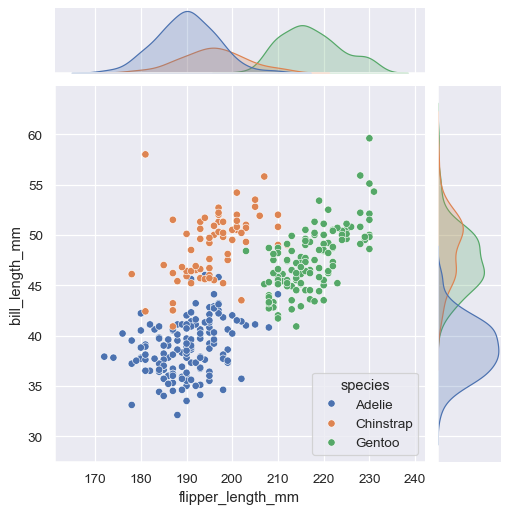
Algunas funciones de Seaborn combinan varios tipos de gráficos para ofrecer rápidamente resúmenes informativos de un conjunto de datos. Una de ellas, `src` jointplot(), se centra en una única relación. Representa gráficamente la distribución conjunta entre dos variables junto con la distribución marginal de cada variable:
penguins = sns.load_dataset("penguins")
sns.jointplot(data=penguins, x="flipper_length_mm", y="bill_length_mm", hue="species")
../_images/introduction_27_0.png

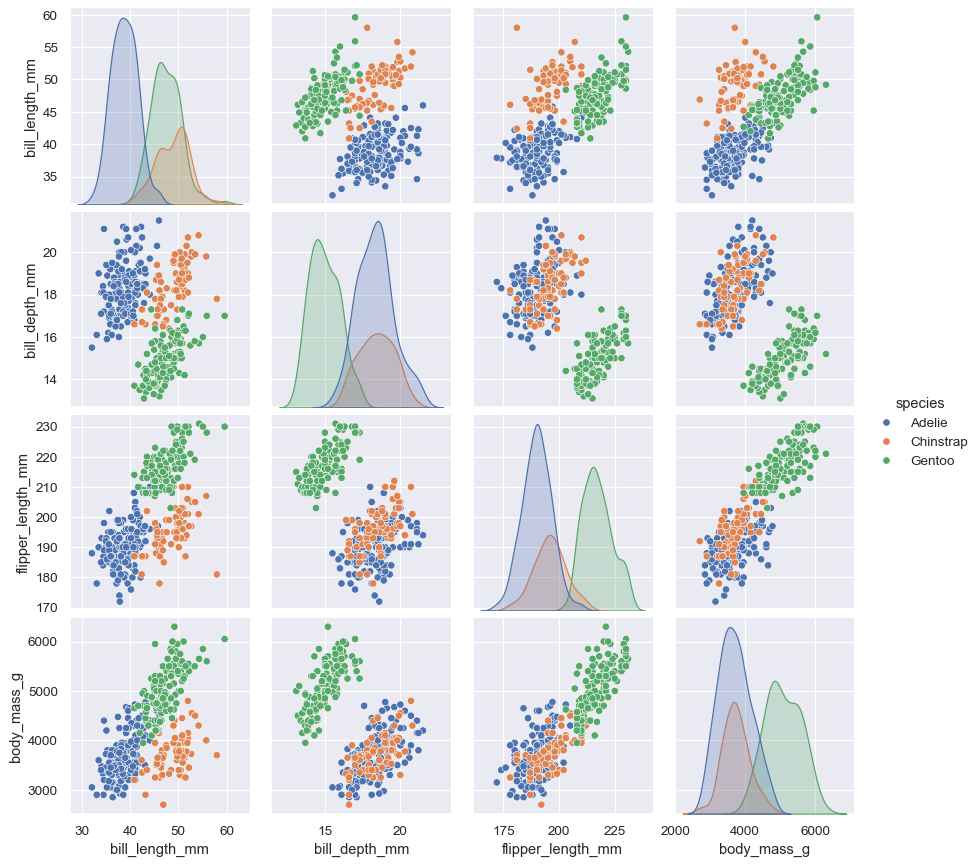
La otra, pairplot(), adopta una perspectiva más amplia: muestra las distribuciones conjuntas y marginales para todas las relaciones por pares y para cada variable, respectivamente:

sns.pairplot(data=penguins, hue="species")
../_images/introduction_29_0.png

Herramientas de nivel inferior para la creación de figuras 

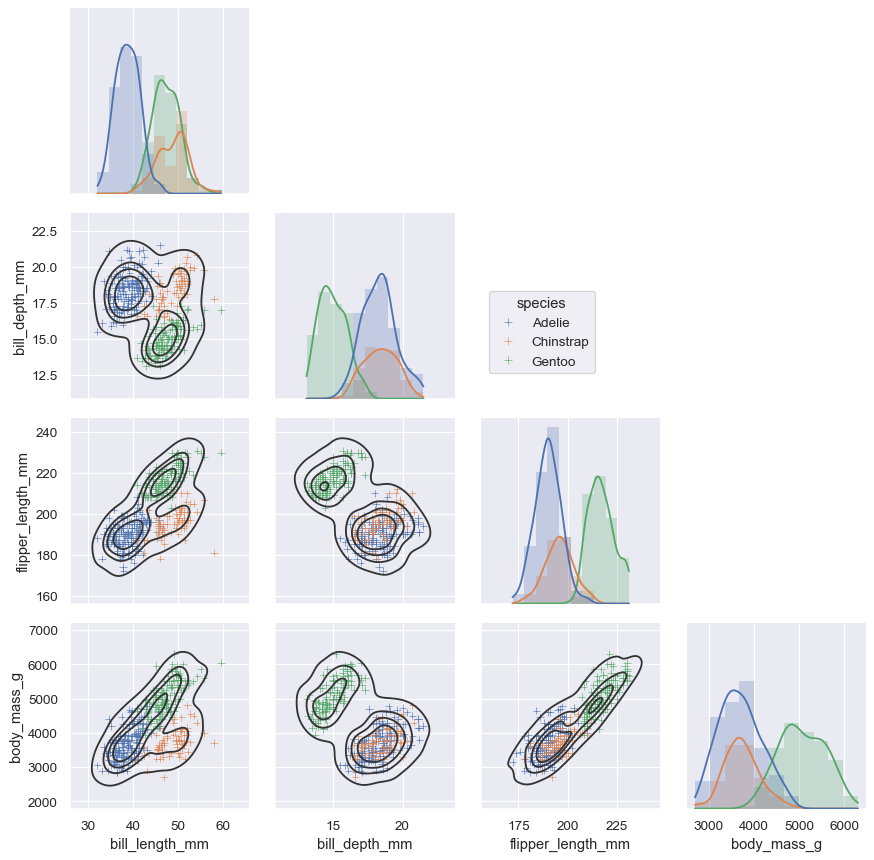
Estas herramientas funcionan combinando funciones de trazado a nivel de ejes con objetos que gestionan el diseño de la figura, vinculando la estructura de un conjunto de datos a una cuadrícula de ejes . Ambos elementos forman parte de la API pública y se pueden usar directamente para crear figuras complejas con solo unas pocas líneas de código adicionales.

g = sns.PairGrid(penguins, hue="species", corner=True)
g.map_lower(sns.kdeplot, hue=None, levels=5, color=".2")
g.map_lower(sns.scatterplot, marker="+")
g.map_diag(sns.histplot, element="step", linewidth=0, kde=True)
g.add_legend(frameon=True)
g.legend.set_bbox_to_anchor((.61, .6))
../_images/introduction_31_0.png

Valores predeterminados con opiniones definidas y personalización flexible 

Seaborn crea gráficos completos con una sola llamada a función: cuando sea posible, sus funciones agregarán automáticamente etiquetas de ejes informativas y leyendas que explican las asignaciones semánticas en el gráfico.

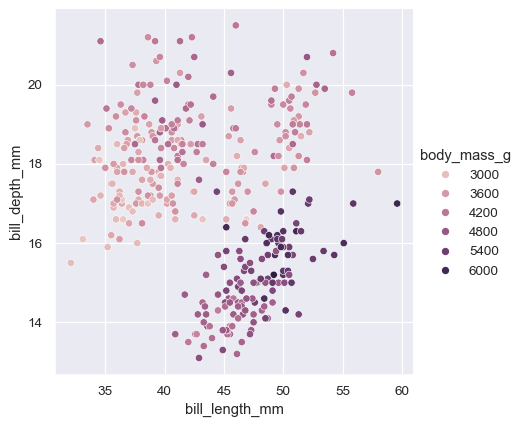
En muchos casos, seaborn también elegirá valores predeterminados para sus parámetros según las características de los datos. Por ejemplo, las asignaciones de color que hemos visto hasta ahora usaban distintos tonos (azul, naranja y, a veces, verde) para representar diferentes niveles de las variables categóricas asignadas hue. Al asignar una variable numérica, algunas funciones cambiarán a un gradiente continuo.

sns.relplot(
    data=penguins,
    x="bill_length_mm", y="bill_depth_mm", hue="body_mass_g"
)
../_images/introduction_33_0.png

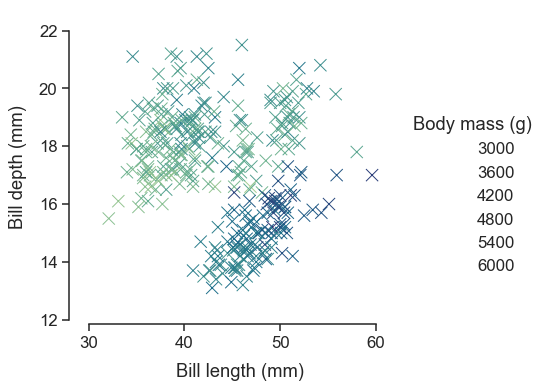
Cuando estés listo para compartir o publicar tu trabajo, probablemente querrás perfeccionar la figura más allá de lo que ofrecen las opciones predeterminadas. Seaborn permite varios niveles de personalización. Define múltiples temas integrados que se aplican a todas las figuras, sus funciones tienen parámetros estandarizados que pueden modificar las asignaciones semánticas de cada gráfico, y se pasan argumentos de palabras clave adicionales a los gráficos de Matplotlib, lo que permite un mayor control. Una vez que hayas creado un gráfico, sus propiedades se pueden modificar tanto a través de la API de Seaborn como accediendo a la capa de Matplotlib para realizar ajustes más precisos.
sns.set_theme(style="ticks", font_scale=1.25)
g = sns.relplot(
    data=penguins,
    x="bill_length_mm", y="bill_depth_mm", hue="body_mass_g",
    palette="crest", marker="x", s=100,
)
g.set_axis_labels("Bill length (mm)", "Bill depth (mm)", labelpad=10)
g.legend.set_title("Body mass (g)")
g.figure.set_size_inches(6.5, 4.5)
g.ax.margins(.15)
g.despine(trim=True)
../_images/introduction_35_0.png

Relación con matplotlib 

La integración de Seaborn con matplotlib le permite usarlo en los numerosos entornos que admite matplotlib, incluyendo análisis exploratorio en cuadernos, interacción en tiempo real en aplicaciones GUI y salida de archivo en varios formatos rasterizados y vectoriales.

Si bien puedes ser productivo usando solo las funciones de seaborn, la personalización completa de tus gráficos requerirá cierto conocimiento de los conceptos y la API de matplotlib. Un aspecto de la curva de aprendizaje para los nuevos usuarios de seaborn será saber cuándo es necesario recurrir a matplotlib para lograr una personalización específica. Por otro lado, los usuarios que ya conocen matplotlib encontrarán que gran parte de sus conocimientos son transferibles.

Matplotlib cuenta con una API completa y potente; prácticamente cualquier atributo de la figura se puede modificar a tu gusto. La combinación de la interfaz de alto nivel de Seaborn y la profunda capacidad de personalización de Matplotlib te permitirá explorar rápidamente tus datos y crear gráficos que se pueden adaptar para obtener un producto final con calidad de publicación .

Próximos pasos 

Tienes varias opciones para continuar. Podrías empezar aprendiendo a instalar Seaborn . Una vez hecho esto, puedes explorar la galería de ejemplos para hacerte una idea más amplia de los gráficos que Seaborn puede generar. O bien, puedes leer el resto de la guía del usuario y el tutorial para obtener información más detallada sobre las diferentes herramientas y su función. Si tienes en mente un gráfico específico y quieres saber cómo crearlo, puedes consultar la referencia de la API , que documenta los parámetros de cada función y muestra numerosos ejemplos para ilustrar su uso.

Entradas recientes

¿Existen herramientas para RCA (Root Cause Analysis) en Python?

Fuente: Gemini IA.  Sí, existen librerías especializadas en Python para realizar análisis de causa raíz (Root Cause Analysis o RCA), especi...

Entradas Populares