""

viernes, 13 de febrero de 2026

Python For Data Science. Transformación de datos

 Fuente: Google & Coursera

Otros enfoques de la transformación de datos
Estado: Traducido automáticamente del Inglés

COMO SABE, los datos nos llegan en muchas formas diferentes. Para los tipos de datos categóricos o cualitativos, los profesionales de datos a menudo necesitan transformar (o codificar) este tipo de datos en dígitos numéricos para completar su análisis, diseñar su visualización de datos o construir su algoritmo de Aprendizaje automático. En esta lectura, aprenderá sobre los dos tipos principales de codificación de datos categóricos y cuándo utilizar cada tipo.

Codificación de etiquetas

Ya ha aprendido sobre la codificación de etiquetas, que es un tipo de técnica de transformación de datos en la que a cada valor de datos se le asigna un número distinto en lugar de un valor cualitativo.

Si recuerdas el vídeo, en el ejemplo se codificaban con etiquetas los tipos de setas:

Tipo de seta

Código

Trufa negra

0

Botón

1

Cremini

2

Erizo

3

Rey Trompeta

4

Morilla

5

Portobello

6

Shiitake

7

Seta

8

Como puede deducirse, para este hipotético conjunto de datos sobre setas, a cada tipo de seta se le asignó su propio número, empezando por cero.

Algunos problemas potenciales con la codificación de etiquetas

Imagine que está analizando un conjunto de datos con categorías de géneros musicales. Usted codifica las etiquetas "Blues", "Electronic Dance Music (EDM)", "Hip Hop", "Jazz", "K-Pop", "Metal" y "Rock" con los siguientes valores numéricos: "1, 2, 3, 4, 5, 6 y 7".

Con esta codificación de etiquetas, el modelo de Aprendizaje automático resultante podría derivar no sólo una clasificación, sino también una conexión más estrecha entre Blues (1) y EDM (2) debido a lo cerca que están numéricamente que, por ejemplo, Blues(1) y Jazz(4). Además de estas supuestas relaciones (que puede que quiera o no incluir en su análisis), también debe observar que cada código es equidistante del otro en la secuencia numérica, es decir, 1 a 2 está a la misma distancia que 5 a 6, etc. La pregunta es si esa relación equidistante representa fielmente las relaciones entre los géneros musicales de su conjunto de datos Por hacer otra pregunta, después de la codificación, ¿la visualización o el modelo que construya tratará las etiquetas codificadas como una clasificación?

Lo mismo podría decirse del ejemplo anterior de las setas. Tras codificar las etiquetas de los tipos de setas, ¿está usted satisfecho con el hecho de que las setas estén ahora en un supuesto orden de clasificación con las setas de botón en primer lugar y las setas de sapo en octavo lugar?

En resumen, la codificación de etiquetas puede introducir relaciones no deseadas entre los datos categóricos de su conjunto de datos. Cuando tome decisiones sobre la codificación de etiquetas, tenga en cuenta el algoritmo que aplicará a los datos y cómo puede afectar o no a los datos categóricos codificados con etiquetas.

Afortunadamente, existe otro método para la codificación categórica que puede ayudar con estos problemas potenciales.

Codificación one-hot

ASÍ COMO aprendió en un vídeo anterior, puede crear variables ficticias en Python. Si recuerdas, una variable ficticia es una variable con valores de 0 ó 1, que indican la presencia o ausencia de algo. La idea es crear una nueva columna para cada tipo de categoría, y luego para cada valor indicar un 0 o un 1 - 0 significa, no, y 1 significa, sí.

Esta creación de dummies se denomina Codificación one-hot. Como recordatorio, una tabla con Codificación one-hot termina así:

n/A

Leve

Disperso

Fuerte

Grave

0

1

0

0

0

1

1

0

0

0

2

0

1

0

0

3

0

0

1

0

4

0

0

0

1

5

0

0

0

1

6

0

0

0

1

7

0

0

0

1

8

0

0

1

0

9

0

1

0

0

10

1

0

0

0

11

1

0

0

0

12

0

1

0

0

Encontrará que los valores del conjunto de datos de rayos que se tratan en el vídeo están etiquetados como "leves" y tienen un "1" "Leve" se refiere al cuartil más bajo de los recuentos de rayos en el conjunto de datos. Para cualquier otro valor de la columna "leve" que NO sea leve, hay un cero en esa celda. Con este método, resolvemos el problema de las relaciones no intencionadas y problemáticas que presentaba la codificación de etiquetas.

Pero la codificación one-hot presenta sus propios problemas, sobre todo cuando se trata de regresión logística y lineal. Aprenderá más sobre esto en un curso futuro.

Codificación por etiquetas o codificación one-hot: ¿Cómo decidir?

No hay una respuesta sencilla a la pregunta de si debe utilizar la codificación por etiquetas o la codificación one-hot. La decisión debe tomarse caso por caso, o conjunto de datos por conjunto de datos. Pero hay algunas directrices que pueden ayudarle.

Utilice la codificación de etiquetas cuando:

  • Hay un gran número de variables categóricas diferentes - porque la codificación de etiquetas utiliza muchos menos datos que la codificación one-hot

  • Los valores categóricos tienen un orden particular (por ejemplo, los grupos de edad pueden agruparse del más joven al más viejo o del más viejo al más joven)

  • Tiene previsto utilizar un árbol de decisiones o un modelo de aprendizaje automático de bosque aleatorio

Utilice la codificación one-hot cuando:

  • Hay una cantidad relativamente pequeña de variables categóricas - porque la codificación one-hot utiliza muchos más datos que la codificación de etiquetas.

  • Las variables categóricas no tienen un orden determinado

  • Se utiliza un modelo de Aprendizaje automático en combinación con la Reducción de dimensionalidad (como el Análisis de componentes principales (PCA))

Puntos clave

La codificación de etiquetas y la codificación one-hot son técnicas para transformar datos categóricos en datos numéricos. La codificación de etiquetas es la mejor para un gran número de variables categóricas diferentes y para categorías que tienen un orden inherente. La codificación one-hot es mejor para cantidades más pequeñas de variables categóricas y para categorías que no tienen orden.
Python for Data Science. Valores atípicos

 Fuente: Google & Coursera.

Guía de referencia: Cómo tratar los valores atípicos
Estado: Traducido automáticamente del Inglés

Información:
Este elemento incluye contenido que aún no se tradujo a tu idioma preferido.

Quizá quieras guardar una copia de esta guía para futuras consultas. Puede utilizarla como recurso para prácticas adicionales o en sus futuros proyectos profesionales. Para acceder a una versión descargable de este elemento del curso, haga clic en el enlace que aparece a continuación y seleccione "Usar plantilla."

Guía de referencia: Cómo tratar los valores atípicos

O

Si no dispone de una cuenta de Google, puede descargar el elemento directamente desde el siguiente archivo adjunto.

Anteriormente, has visto dos vídeos sobre cómo detectar valores atípicos y por qué su tratamiento puede ser una parte importante de la limpieza de datos. En este punto, es probable que tenga una buena comprensión de esto. Es importante no sólo detectar los valores atípicos, sino también tener un plan para ellos.

Eso es precisamente lo que revisará en esta lectura. Una vez detectados los valores atípicos en el conjunto de datos -ya sean globales, contextuales o colectivos-, ¿cómo tratarlos? En lo que respecta al Análisis exploratorio de datos (EDA), existen tres formas principales de tratar los valores atípicos: eliminarlos, reasignarlos o dejarlos como están.

Mantener los valores atípicos tal como están, eliminarlos o reasignarlos es una decisión que se toma en cada conjunto de datos. Para ayudarle a tomar la decisión, puede empezar con estas directrices generales:

  • Elimínelos: Si está seguro de que los valores atípicos son equivocaciones, erratas o errores y el conjunto de datos se utilizará para modelado o aprendizaje automático, entonces es más probable que decida eliminar los valores atípicos. De las tres opciones, ésta es la que menos utilizará.

  • Reasignarlos: Si el conjunto de datos es pequeño y/o los datos se utilizarán para el modelado o el aprendizaje automático, es más probable que elija una ruta de derivación de nuevos valores para reemplazar los valores atípicos.

  • Dejarlos: Para un conjunto de datos en el que se planea hacer EDA/análisis y nada más, o para un conjunto de datos que se está preparando para un modelo que es resistente a los valores atípicos, lo más probable es que los deje.

En los vídeos sobre valores atípicos se explica detalladamente cómo tratar los valores atípicos cuando los deja en el conjunto de datos. En esta lectura, usted aprenderá acerca de algunas técnicas para eliminar y reasignar los valores atípicos.

1. Borrarlos.

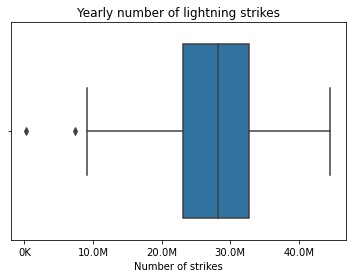
Para una forma de eliminar valores atípicos, recuerde la codificación que vio en el video tutorial sobre valores atípicos. En ese video, el instructor codificó un Diagrama de caja para ayudarlo a visualizar dos valores atípicos diferentes, como se muestra aquí:

Nota: El siguiente bloque de código no es interactivo.

>>box = sns.boxplot(x=df['number_of_strikes'])
>>g = plt.gca()
>>box.set_xticklabels(np.array([readable_numbers(x) for x in g.get_xticks()]))
>>plt.xlabel('Number of strikes')
>>plt.title('Yearly number of lightning strikes');


Se muestra un diagrama de caja con dos valores atípicos a la izquierda, fuera del bigote izquierdo.

El instructor luego usó el siguiente código para encontrar el límite inferior-8.6M.

>># Calculate 25th percentile of annual strikes
>>percentile25 = df['number_of_strikes'].quantile(0.25)

>># Calculate 75th percentile of annual strikes
>>percentile75 = df['number_of_strikes'].quantile(0.75)

>># Calculate interquartile range
>>iqr = percentile75 - percentile25

>># Calculate upper and lower thresholds for outliers
upper_limit = percentile75 + 1.5 * iqr
lower_limit = percentile25 - 1.5 * iqr

>>print('Lower limit is: ', lower_limit)

>>>Lower limit is: 8585016.625

A continuación, se utilizó una máscara booleana para filtrar el marco de datos de modo que sólo contuviera filas en las que el número de huelgas fuera inferior al límite inferior.

>>print(df[df['number_of_strikes'] < lower_limit])

>>> number_of_strikes year 1 209166 2019 33 7378836 1987

Una vez que conozca los puntos de corte para los valores atípicos, si desea eliminarlos,
puede utilizar una máscara booleana para seleccionar todas las filas tales que:
límite inferior ≤ valores ≤ límite superior.

>>mask = (df['number_of_strikes'] >= lower_limit) & (df['number_of_strikes'] <=
>>upper_limit)

>>df = df[mask].copy()
>>print(df)

>>>

number_of_strikes year 0 15620068 2020 2 44600989 2018 3 35095195 2017 4 41582229 2016 5 37894191 2015 6 34919173 2014 7 27600898 2013 8 28807552 2012 9 31392058 2011 10 29068965 2010 11 30100585 2009 12 29790934 2008 13 30529064 2007 14 33292382 2006 15 38168699 2005 16 40023951 2004 17 39092327 2003 18 29916767 2002 19 25470095 2001 20 26276135 2000 21 27758681 1999 22 28802221 1998 23 26986915 1997 24 26190094 1996 25 22763540 1995 26 25094010 1994 27 24206929 1993 28 16371876 1992 29 16900934 1991 30 15839052 1990 31 14245186 1989 32 9150440 1988

A continuación, considerará reasignar los valores atípicos derivando nuevos valores que se ajusten mejor al conjunto de datos.

2. Reasignarlos.

En lugar de eliminar los valores atípicos, siempre puede reasignarlos, es decir, cambiar los valores por otros que se ajusten a la distribución general del conjunto de datos. Hay dos formas comunes de hacerlo, pero se pueden utilizar muchas formas diferentes, dependiendo de su caso de uso:

1. Cree un suelo y un techo en un cuantil: Por ejemplo, puede colocar muros en los percentiles 90 y 10 de la distribución de los valores de los datos. Cualquier valor por encima de la marca del 90% o por debajo de la marca del 10% se cambian para encajar dentro de las paredes que establezca. He aquí un ejemplo de cómo podría ser ese código:

>># Calculate 10th percentile
>>tenth_percentile = np.percentile(df['number_of_strikes'], 10)

>># Calculate 90th percentile
>>ninetieth_percentile = np.percentile(df['number_of_strikes'], 90)

>># Apply lambda function to replace outliers with thresholds defined above
>>df['number_of_strikes'] = df['number_of_strikes'].apply(lambda x: (
>>    tenth_percentile if x < tenth_percentile 
>>    else ninetieth_percentile if x > ninetieth_percentile 
>>    else x))

>>>
0 15620068.0 1 14657650.6 2 38815238.6 3 35095195.0 4 38815238.6 5 37894191.0 6 34919173.0 7 27600898.0 8 28807552.0 9 31392058.0 10 29068965.0 11 30100585.0 12 29790934.0 13 30529064.0 14 33292382.0 15 38168699.0 16 38815238.6 17 38815238.6 18 29916767.0 19 25470095.0 20 26276135.0 21 27758681.0 22 28802221.0 23 26986915.0 24 26190094.0 25 22763540.0 26 25094010.0 27 24206929.0 28 16371876.0 29 16900934.0 30 15839052.0 31 14657650.6 32 14657650.6 33 14657650.6 Name: number_of_strikes, dtype: float64


2. Imputar la media: En algunos casos, puede ser mejor reasignar todos los valores atípicos para que coincidan con la mediana o el valor medio. Esto garantizará que la mediana y la distribución se basen únicamente en los valores no atípicos, excluyendo los valores atípicos originales. La imputación o reasignación de valores puede ser bastante sencilla si ya ha encontrado los valores atípicos. El siguiente bloque de código calcula la mediana de los valores mayores que el límite inferior. A continuación, imputa la mediana de los valores inferiores al límite inferior.

>># Calculate median of all NON-OUTLIER values
>>median = np.median(df['number_of_strikes'][df['number_of_strikes'] >= lower_limit])

>># Impute the median for all values < lower_limit
>>df['number_of_strikes'] = np.where(df['number_of_strikes'] < lower_limit, median, df['number_of_strikes'])

>>>
[ 15620068. 28804886.5 44600989. 35095195. 41582229. 37894191. 34919173. 27600898. 28807552. 31392058. 29068965. 30100585. 29790934. 30529064. 33292382. 38168699. 40023951. 39092327. 29916767. 25470095. 26276135. 27758681. 28802221. 26986915. 26190094. 22763540. 25094010. 24206929. 16371876. 16900934. 15839052. 14245186. 9150440. 28804886.5]

Nota: Fuera de EDA, el Aprendizaje automático y el modelado de regresión tienen variaciones más complejas al tratar con valores atípicos. Aprenderá más sobre estos temas más adelante.

Puntos clave

Después de detectar los valores atípicos en un conjunto de datos, es esencial que determine una estrategia para manejarlos. Debido a que cada conjunto de datos y problema basado en datos es diferente, su estrategia variará. En la mayoría de los casos, tendrá que elegir entre eliminar, reasignar o dejar los valores atípicos.

jueves, 12 de febrero de 2026

MatPlotLib. WordCloud

El WordCloud función desde wordcloud permite crear nubes de palabras en Python. La función proporciona varios métodos, pero generate es el que necesitas para crear una nube de palabras de una cadena de texto. Tenga en cuenta que, de forma predeterminada, el tamaño de la imagen es 400x200, pero puede personalizar el tamaño con width y height, como en el ejemplo siguiente o usando scale (el valor predeterminado es 1), que se recomienda para nubes de palabras grandes.

Vale la pena mencionar que si quieres que las palabras se repitan, establece repeat = True. Esto es muy útil para crear una nube de palabras a partir de una sola palabra o textos pequeños.


Ejemplo 1:

>>import matplotlib.pyplot as plt
>>from wordcloud import WordCloud

>>text = input("Favor ingresar el texto para la nube de palabras: ")
>>wc = WordCloud(width = 300, height = 300, repeat = "true").generate(text)

>># Remove the axis and display the data as image
>>plt.axis("off")
>>plt.imshow(wc, interpolation = "bilinear")

>># plt.show()


Ejemplo 2:

>>import numpy as np
>>import matplotlib.pyplot as plt
>>from wordcloud import WordCloud

>>text = input("Favor ingresar el texto para Wordcloud circular: ")

>># Circle mask
>>x, y = np.ogrid[:300, :300]
>>mask = (x - 150) ** 2 + (y - 150) ** 2 > 130 ** 2
>>mask = 255 * mask.astype(int)

>>wc = WordCloud(background_color = "white", repeat = True, mask = mask)
>>wc.generate(text)

>>plt.axis("off")
>>plt.imshow(wc, interpolation = "bilinear")

>># plt.show()

Ejemplo 3:

>>import numpy as np
>>import matplotlib.pyplot as plt
>>from wordcloud import WordCloud
>>from PIL import Image
>>from io import BytesIO
>>mport requests

>>text = "PPI, Python Para Ingenieros"

>># From URL
>>response = requests.get("https://raw.githubusercontent.com/R-CoderDotCom/samples/main/wordcloud-mask.jpg")
>>mask = np.array(Image.open(BytesIO(response.content)))

>># From local
>># mask = np.array(Image.open("file_name.png"))

>>wc = WordCloud(background_color = "white", repeat = True, mask = mask)
>>wc.generate(text)

>>plt.axis("off")
>>plt.imshow(wc, interpolation = "bilinear")

>>plt.show()


Entradas recientes

Estructura secuencial. solución matemática vs programación

 **Ejemplo resuelto # 4:** Fuente: Capitulo 3 del libro "Lógica de programación de Efraín Oviedo" A la mamá de Juan le preguntan s...

Entradas Populares